A expressão “rodar a própria namorada IA” faz parecer um único programa. Na prática são três peças que conversam entre si, e entender qual peça faz o quê poupa a maior parte da frustração.
As três peças
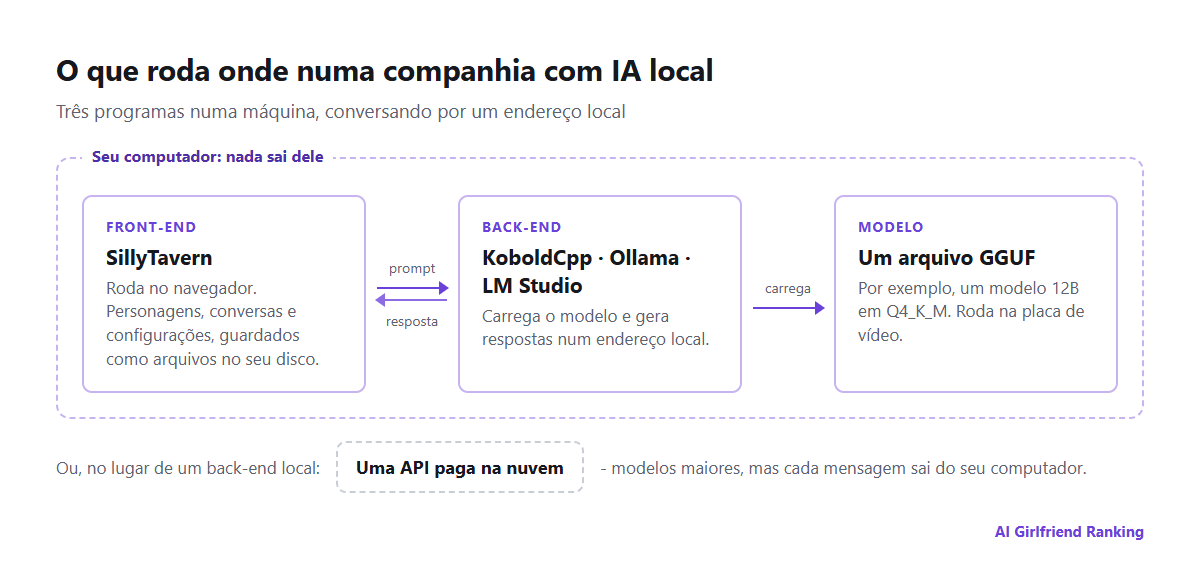
O que fala com o quê numa configuração local típica.
O front-end é o que você vê: janelas de chat, personagens, avatares, configurações. O SillyTavern é a escolha padrão para chat com personagens. Roda no navegador, guarda personagens e conversas como arquivos no seu disco e conecta a quase qualquer back-end. Ele mesmo não gera texto.
O back-end carrega o modelo e gera as respostas. O KoboldCpp é um único programa, sem instalação, popular para roleplay porque expõe todas as configurações de geração. O Ollama é o jeito mais fácil de pôr um modelo para rodar com poucos comandos. O LM Studio é um app de desktop com um navegador de modelos amigável. Qualquer um deles serve o modelo num endereço local ao qual o front-end se conecta.
O modelo é um arquivo grande, em geral no formato GGUF, baixado do Hugging Face. O tamanho dele em parâmetros (8B, 12B, 24B) e a quantização decidem quão bom ele é e que hardware exige.
A questão do hardware
O que decide se um modelo roda bem é a memória da placa de vídeo (VRAM). O modelo precisa caber, mais espaço para a própria conversa. A quantização encolhe os modelos para caber: “Q4_K_M” é o meio-termo comum entre tamanho e qualidade.
| Tamanho do modelo | Memória aprox. em Q4 | Hardware típico | O que esperar |
|---|---|---|---|
| 7-8B | 5-6 GB | Placa de vídeo de 8 GB | Coerente, rápido, esquece detalhes em cenas longas |
| 12-14B | 9-10 GB | Placa de 12 GB | Personagens e prosa visivelmente melhores |
| 22-24B | 14-16 GB | Placa de 16-24 GB | Perto dos bons apps hospedados para roleplay |
| 70B | 40 GB+ | Duas placas ou um Mac com muita memória | Excelente, lento e caro |
Esses números são aproximados: contexto mais longo exige mais memória por cima. Os Macs com Apple Silicon compartilham memória entre processador e gráficos, então um MacBook de 32 GB roda modelos que uma placa de 12 GB não roda. Um modelo que não cabe vaza para o processador principal e se arrasta; se as respostas chegam a poucas palavras por segundo, troque por um modelo menor antes de tentar uma quantização mais agressiva. Um modelo menor com boa qualidade costuma superar um maior espremido demais.
O que você ganha
- Privacidade que não depende de uma política. Nada sai da máquina. Sem prazo de retenção, sem treinamento, sem acesso de funcionários, nada para excluir depois.
- Nenhum filtro além do próprio modelo. Você escolhe o modelo, inclusive os ajustados especificamente para roleplay. O piso legal sobre conteúdo continua valendo para você, mas nenhum operador acrescenta regras por cima.
- Sem assinatura e sem créditos. Gere o quanto quiser.
- Personagens que são seus. Os cartões de personagem são imagens PNG comuns com a ficha do personagem embutida. Eles migram entre front-ends e nenhuma atualização pode tirá-los de você.
- Estabilidade. Um modelo que funciona hoje funciona do mesmo jeito daqui a cinco anos. Ninguém pode trocá-lo debaixo de você, o risco descrito em quando sua companhia com IA muda da noite para o dia.
O que você abre mão
- Tempo de configuração. Conte com uma noite para o primeiro chat funcionando e semanas de ajustes se você gosta disso.
- A memória é com você. Os apps hospedados resumem e guardam fatos sobre você em silêncio. Localmente, você cuida disso com os lorebooks, os resumos e as notas de personagem do SillyTavern, os mesmos três mecanismos explicados em como funciona a memória de uma companhia com IA, só que com os controles expostos.
- Imagens e voz são projetos separados. Gerar imagens precisa de um modelo próprio e, em geral, de mais memória gráfica; voz precisa de ferramentas de reconhecimento e síntese de fala. Tudo é possível, nada é automático.
- O celular é desajeitado. Dá para abrir o front-end pelo celular no Wi-Fi de casa. Usar fora de casa significa expor seu computador à internet, o que exige cuidado.
- Teto de qualidade. Os melhores modelos hospedados são maiores que qualquer coisa que a maioria das pessoas consegue rodar em casa, sobretudo na consistência de longo prazo.
O caminho do meio, e a pegadinha
Muita gente roda o SillyTavern na própria máquina, mas o conecta a uma API paga na nuvem em vez de a um modelo local. Você fica com o controle do front-end e os arquivos de personagem, com modelos muito maiores e com cobrança por mensagem, que pode sair barata no uso leve.
Só que não é privado. Cada mensagem vai para o provedor da API, sob os registros, a retenção e as regras de conteúdo dele, muitas vezes mais rígidas com conteúdo de roleplay do que os apps dedicados de companhia. É outra troca, não uma configuração local.
Noções básicas de segurança
- Baixe software apenas das páginas oficiais do projeto no GitHub ou do site do próprio projeto.
- Baixe modelos de autores conhecidos no Hugging Face e prefira arquivos GGUF, que contêm dados do modelo e não código.
- Leia a licença do modelo. Algumas restringem o uso comercial; poucas restringem certos conteúdos.
- Mantenha o SillyTavern restrito à sua própria máquina ou rede doméstica, a menos que você tenha configurado uma senha e entenda o que está expondo.
O SillyTavern é desenvolvido de forma aberta no GitHub.
Para quem serve
Rode uma companhia localmente se a privacidade é sua principal preocupação, se você já tem hardware capaz ou se gosta de configurar tanto quanto de usar. Fique com um app hospedado se quer voz, imagens e memória longa funcionando de saída ou se conversa principalmente no celular. Nosso guia para escolher o primeiro app cobre esse caminho. Muita gente acaba com os dois: um app hospedado pela conveniência e uma configuração local para as conversas que prefere não guardar em lugar nenhum.